把 AI 编排塞进一个真实产品:TripSmith 复盘(延迟、失败、布局还原)
一个对标携程 AI 行程助手的开源实现。真正难的不是调通大模型,而是三件事:把参考实现量清楚再动手、把载荷从 118KB 压到 9.2KB、以及在网关必然失败的前提下设计失败路径。记录六个决定性取舍与实测数据,包括推理参数为什么必须走 extra_body、轮换指针为什么会跳过模型、开放时间按天摘要为什么会算错。
关键词:LLM 编排、SSE、payload 工程、模型轮换、降级策略、布局还原
一句话结论
调通大模型是最简单的一步。 真正决定这个项目能不能用的,是三件跟模型无关的事:
- 把「参考实现」量清楚,再动手;
- 把载荷压到链路能承受的量级;
- 在「网关一定会有概率失败」的前提下设计失败路径。
下面按这三点展开,每个结论都带实测数字。
一、复刻:先用 DOM 量,再写代码
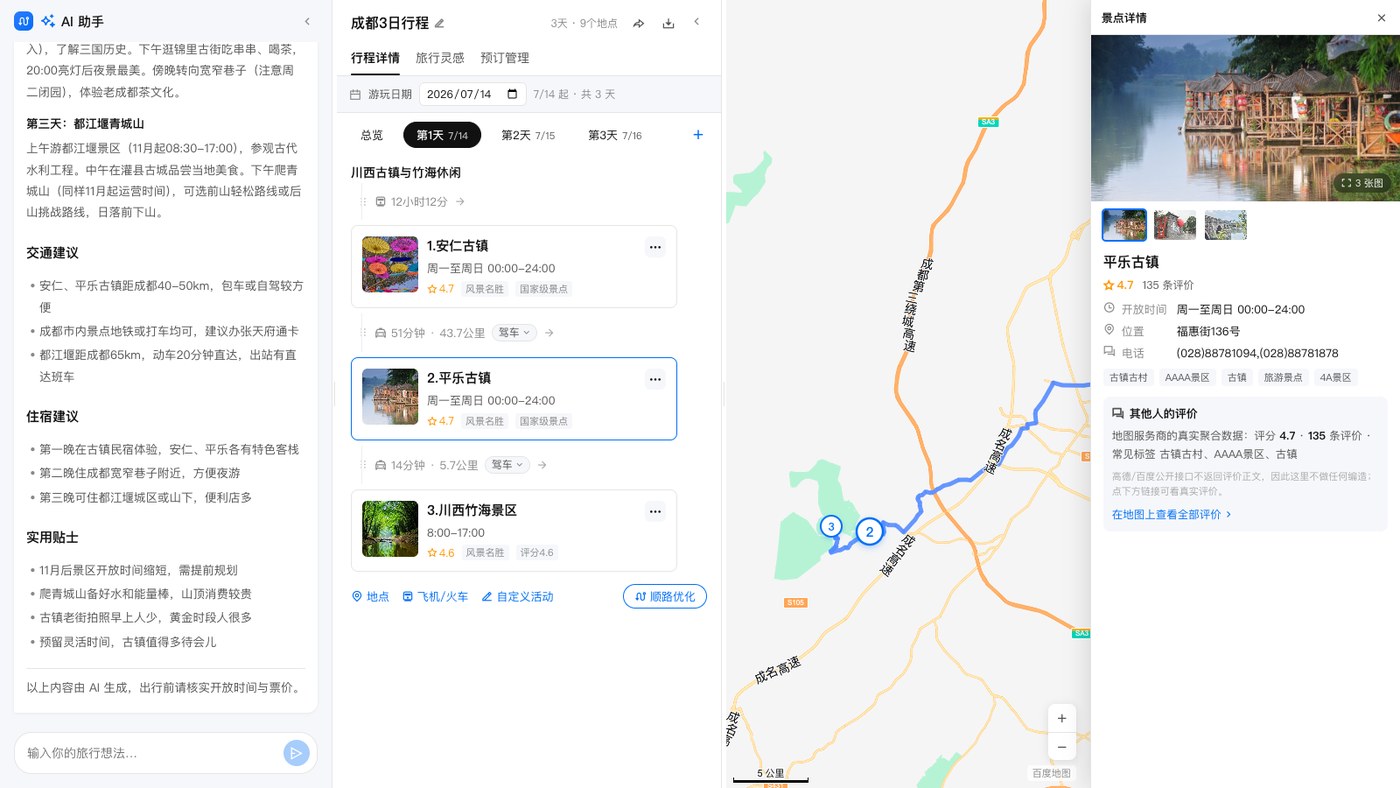
目标是对标市面上的 AI 行程助手,尽量贴近它的布局与交互。第一版凭截图目测,被一句话打回:「你这个 UI 布局和参考的都不一样」。
教训很直接:凭截图写,永远对不上。正确做法是把参考页的尺寸测出来:
- 三栏宽度(460 / 460 / 自适应);
- 卡片封面 64×64、标题字号、meta 行间距;
- 划分布局的那个断点。
测完之后布局一次到位。更关键的是——这套测量必须固化成一个可重复执行的检查,否则下次改动又会悄悄跑偏。
于是写了布局守卫脚本:横跨 1600 → 420px 九个宽度,对每个宽度断言三件事:
- 每个面板尺寸非零;
- 每个面板至少 40% 落在视口内;
- 控制台无报错。
它上线第二天就抓到一个真实回归:某个陈旧的 @media (max-width:1280px) 把布局改成纵向,导致行程面板被推到 y=900、地图到 y=1800,用户在 1024~1280px 的笔记本上只能看见会话栏,另外两栏全在屏幕外。
这类 bug 靠肉眼极难发现——因为你自己的显示器往往不在这个宽度区间。
二、延迟:模型选型是第一性能杠杆
最初的诉求是「和携程一样 40 秒左右出内容」。第一版实测 100 秒以上。
逐段埋点后结论很反直觉:代码一行没改,只换模型名,端到端从 100s+ 掉到 20s 量级。
| 模型类型 | 编排调用耗时 | 行程首次可见 | 全部完成 |
|---|---|---|---|
| 推理型 | 51~103s | 47~108s | 69~158s |
| 轻量非推理 | 3~6s | 4~6s | 18~46s |
原因是推理型模型把大量时间花在不显示给用户的隐藏推理 token 上。它的输出长度没变,但你为不可见的思考付了双倍时间。
所以「AI 产品慢」的第一嫌疑对象不是 prompt、不是并发,而是模型类型。
推理模型必须传思考参数
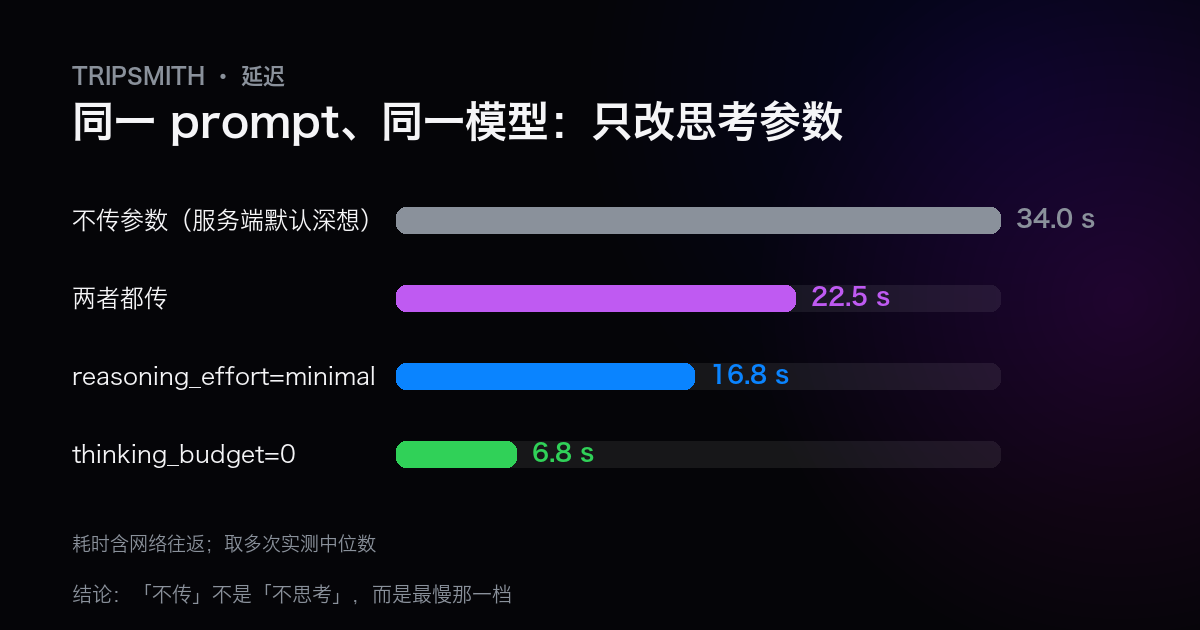
换成推理型模型后还有一层坑。同一个 prompt、同一个模型:
| 是否传思考参数 | 耗时 |
|---|---|
| 不传 | 34.0s |
reasoning_effort=minimal | 16.8s |
thinking_budget=0 | 6.8s |
| 两个都传 | 22.5s |
两个发现:
- 「不传」不是「不思考」,而是「用服务端默认的深度思考」——最慢的那档;
- 把两个开关同时传,反而更慢(22.5s)。所以最终只传
thinking_budget=0。
这里踩了个隐蔽的坑:thinking_budget 不是 OpenAI SDK 声明的参数,直接当关键字传给 create() 会抛 TypeError: unexpected keyword argument。而 TypeError 没有 status_code,会被重试判定逻辑归成「不可重试」——结果三个备用模型在 0.5 秒内全部被判失败。
非标准参数必须走 extra_body(SDK 会原样合并进请求 JSON)。
三、载荷:118KB → 9.2KB
用户报的一个体感问题:「首页点一条行程,等 3.5 秒才跳转,就和卡住一样」。
先分清是「应用慢」还是「链路慢」:
| 测量点 | 结果 |
|---|---|
| 直连服务,详情接口 | 5ms,118540 字节 |
| 经隧道,同一接口 | 2.5~40s(首字节 2.49s,其余是传输) |
| 隧道吞吐估算 | 118540B / 7.4s ≈ 16KB/s |
应用 5ms 就返回了。那 3.5 秒全是传输。接着拆载荷:
| 分块 | 字节 | 占比 |
|---|---|---|
day_list | 111587 | 86% |
chat 历史 | 17571 | 13.5% |
| 其余 | ~640 | 0.5% |
day_list 再往下拆,问题一目了然——全是路线折点:
安仁古镇 → 川西竹海    787 个折点 / 48605 字节
平乐古镇 → 安仁古镇    620 个折点 / 38285 字节
杜甫草堂 → 武侯祠      185 个折点 / 11434 字节
一条 3 天行程 1634 个折点,坐标还带 6 位小数。这是地图服务返回的逐像素级原始轨迹,被原样存库、原样出网。城市尺度下 1 像素约几十米,几百个点里绝大多数对画线毫无贡献。
三层修复
- 折点抽稀:Douglas-Peucker(8 米容差)+ 120 点上限 + 坐标 5 位小数,首尾点强制保留(保证路线仍精确连到 POI 标记上)。
- 响应压缩:gzip。
- 静态资源 Cache-Control:带内容 hash 的资源标
immutable,浏览器不再回源校验;index.html保持no-cache。
结果:
原始            118540 B
抽稀后           42710 B   (-64%)
再 gzip           9170 B   (-92% 相对原始)
折点数  1634 → 284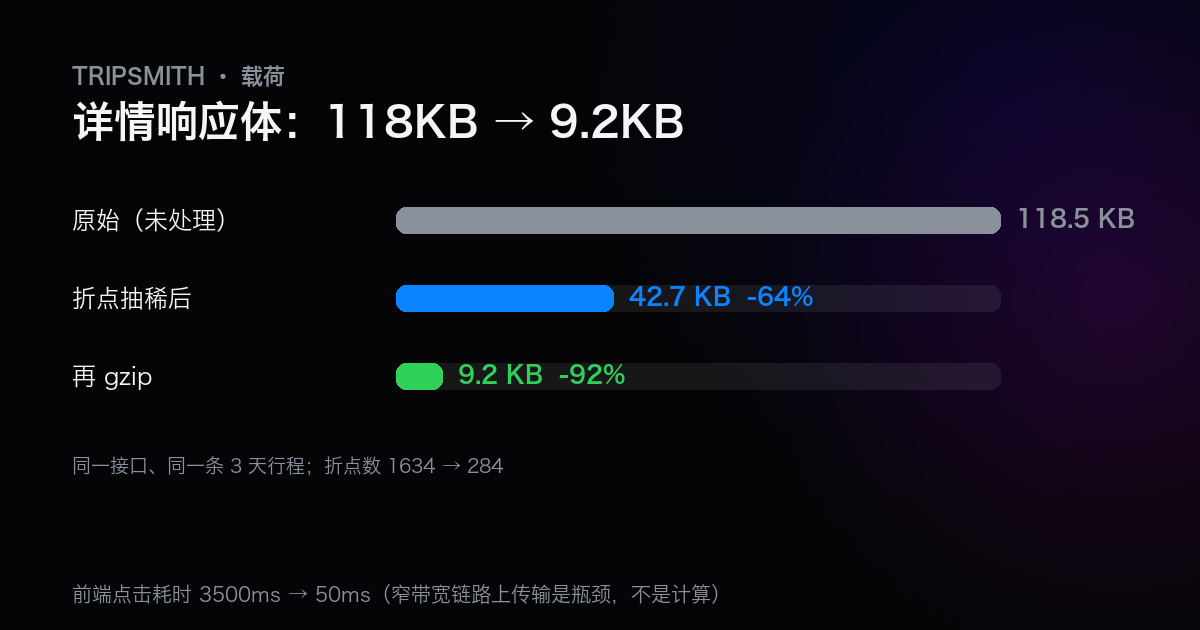
前端点击耗时:3500ms → 44/48/59ms。
最后一个细节值得单说:压缩不能碰 SSE。流式响应一旦被中间件缓冲,规划过程会变成「几十秒一个字都不出」。所幸主流实现默认把 text/event-stream 排除在外,但这条必须写测试锁死——否则哪天换个中间件就静默炸了。
四、失败:不做本地兜底,反而更快可用
产品决策是明确的:网关失败就把具体错误返回给前端并记录,不要拿本地模板冒充 AI 输出。
这条决策的代价是「用户会看到错误」,好处是你永远不会在不知情的情况下拿到假结果。
但只做到「报错」不够。第一个版本报错信息是这样的:
模型输出解析失败用户完全不知道发生了什么,只能反复重试。查下去发现根因是一个「顺手」的写法:
raw = await llm.chat_json(prompt)   # 失败时返回空串(旧接口的设计)
data = json.loads(raw) # 空串 → JSONDecodeError于是「网关连接失败」被误报成「模型输出解析失败」,而且只发了一条思考节点(界面上是折叠的)、没有发错误事件,前端什么也拿不到。
修法有三层:
- 改用返回
(text, error)的接口,失败时下发error事件; - 错误信息逐模型点名,带异常类型、HTTP 状态、上游 body;
- JSON 解析失败时,把模型实际吐出来的前 160 字带上:
模型没有按要求返回 JSON,行程未改动。它实际返回的是(前 160 字):'好的,我来帮你调整…'还有一处更隐蔽的:前端有个兜底
if (!settled) finishAssistant('行程已更新。')只要后端没发正文,前端就替后端宣布成功。配合上面那个「不发错误事件」,用户看到的就是「一次失败的修改 → 界面显示已更新」。
前端永远不应该替后端编造状态。 这句话值得写进规范。
五、多模型轮换:因为故障是按模型错开的
网关的失败不是均匀的。同一分钟内实测:
| 模型 | 状态 |
|---|---|
| 模型 A | 正常,2.6s |
| 模型 B | 连接超时 / 读超时(连不上上游) |
| 模型 C | 有时连接超时,有时 4.1s 正常 |
所以在同一个模型上反复重试,很可能只是陪它一起卡。改成每次重试换下一个模型:
主模型超时 → 备用 1 空正文 → 备用 2 成功线上日志实证:某次编排阶段耗时 64.2s 才成功——正好是两个 30s 超时 + 一次 4s 成功。
三个必须处理的边界
1. 空正文不能当成功。
推理型模型会把 max_tokens 全部烧在思考上,返回空正文 + finish_reason=length。实测出现过 completion_tokens=1400、正文 0 字。这必须判定为失败并换模型,同时把 completion_tokens 报出来——否则你只会看到「模型返回了空内容」这种无法排查的信息。
顺带一个反直觉的结论:max_tokens 要按「链里最费 token 的模型」给。给小了,等于白白牺牲一个备用模型。
2. 不可重试的错误要跳过该模型,而不是整轮失败。
404 / 401 这类错误换模型才有意义,同一模型重试纯属白等。所以要区分「这个模型废了」和「这次请求废了」。
3. 轮换指针不能用取模。
第一版写成 usable[i % len(usable)]。一旦某个模型被标记为坏,usable 变短、下标错位,会把中间那个模型整个跳过去——实测模型 1 失败后直接跳到模型 3,模型 2 从来没被试过。改成「本轮没试过的第一个」。
这三条都有测试,且都来自线上真实故障。
六、开放时间:分号才是分隔符
景点卡片的开放时间来自地图服务,原样显示是这样的(实测 304 字):
1月1日至6月30日,9月1日至12月31日 周二至周日 09:00-17:00开放,最晚进入16:00;
7月1日至8月31日 周二至周日 09:00-20:30开放,最晚进入19:30;周一 全天不开放;
劳动节,端午节,中秋节,国庆节 09:00-20:00开放 最晚进入19:00;每周一不开放用户在界面上已经选定了出发日期,所以完全可以只显示当天适用的那一段:
| 日期 | 显示 |
|---|---|
| 7 月某个周二 | 09:00-20:30(最晚进入19:30) |
| 7 月某个周一 | 当天闭馆 |
| 3 月某个周二 | 09:00-17:00(最晚进入16:00) |
原文不丢:卡片上给一个 ⓘ 圆图标,点开看完整长文本。
两个解析陷阱
第一,逗号不能当分隔符。 1月1日至6月30日,9月1日至12月31日 是同一条规则的两个月份区间。按逗号切会把一条规则劈成两半,匹配全错。
第二,一段规则可能同时有「日期区间」和「星期」两个约束,必须两者都命中。
这是写测试时抓出来的:第一版只校验了日期区间,于是「周一 全天不开放」这条规则在周二也命中,把本该显示的 09:00-20:30 显示成了「当天闭馆」。这种错误非常危险——它看起来完全合理,用户不会怀疑,只会以为景点周二不开门。
不知道就说不知道
节假日规则(元旦 / 春节 / 中秋…)需要农历表,我没有。所以只含节假日名的规则在平日不生效,并且:
- 匹配不到任何规则 → 显示「当天未公示开放时间,建议出行前确认」;
- 绝不猜测,绝不用第一条规则凑数。
宁可显示一句「建议确认」,也不能给一个看起来精确、实际错误的时间。
七、诚实的缺口
项目里有些地方做不到 1:1,我选择在 README 里逐条写清楚,而不是含糊过去:
- 参考实现的「日期」tab 是自绘日历,我用原生
date替代; - 类目 POI 的结果集合不可能与参考实现逐条相同(数据源不同);
- 地图服务不返回评价正文,所以只显示评分与数量,不编造评价;
- 没有真实「建议玩 N 天」的数据来源,所以不编这个字段。
「缺什么」写清楚,比「看起来什么都有」更有用——前者别人能判断要不要用,后者只会在某天突然坑人。
小结
如果只记三句话:
- 先量再写。参考实现的尺寸、断点、间距都能测出来,固化成一个自动化检查,比反复目测省事得多。
- 慢先怀疑模型类型,再怀疑代码。同一份代码换模型能差 5 倍;推理模型的隐藏思考是你付钱但用户看不见的时间。
- 失败路径要比成功路径设计得更认真。网关一定会失败,问题只是今天还是明天。而失败时最坏的做法是假装成功。
至于「AI 编排」本身——把地理结构先在本地算好、让模型只做「审查 + 起名 + 微调」,反而是最先跑通的部分。真正的工程量都在模型之外。